大模型斩杀线
谁斩杀了谁,用最新数据说话
本页能力、成本、速度主榜以 Artificial Analysis 2026-10-25 快照为准(智能指数 v4.3.2 × AA 实测每任务账单 × 72 小时实测速度中位数)。Kimi K3.1 Pro 已获 AA 收录:55 分 / $2.11 / 58 t/s,按模型最高档排第 4,比旧 K3 高 11 分,也超过 DeepSeek 1017 的 45 分。标准 API 单价较 K3 降 33%,但每任务账单并未同步下降——思考 token 增加抵消了单价优势。
最近 30 天模型大战
从 9 月末到 10 月 25 日,主线从「旗舰刷分」转成「能力、账单、速度一起比」:K3.1 Pro 以 55 分成为当前国产模型 AA 最高分,DeepSeek 1017 用 45 分 / $0.26 / 176 t/s 守住性价比,MiniMax 与蚂蚁刷新 Flash 档——已经不能用一句话说谁「全面碾压」谁。
对比图廊 · 四张图看懂 10 月格局
单个数字没有意义,对比才有。这一节把全站四张核心对比图放在一起:档位曲线看同一模型怎么随推理深度变强变贵,斩杀线散点看谁失去了定价权,成本条和速度条看账单与体验的真实差距。所有图共用同一坐标口径:AA 智能指数 v4.3.2 × 每任务成本,2026-10-25 快照;K3.1 Pro 已按 55 分 / $2.11 / 58 t/s 正式入图。
图 ① 推理深度 × 成本曲线:同一个模型,档位越高越聪明也越贵
曲线位置 = 真实差距
- Opus 5.5 降到 high 档($1.82)仍有 54 分
- 比 GPT-6 Astra 拉满 max($3.26 / 53 分)更高分、近半价
- Sonnet 5.5 xhigh($2.01 / 52 分)也摸到 Astra max 近旁
档位边际收益递减
- Opus 5.5:high→max 涨 4 分,账单 ×3.3
- Sonnet 5.5:xhigh→max 涨 4 分,账单 ×2.7
- GPT-6.1 Sol:xhigh→max 涨 1 分,账单 ×1.8
- 日常任务停在 high / xhigh 档通常是甜点
单点模型的位置感
- K3.1 Pro(55 / $2.11):比 Sonnet 5.5 低 1 分,账单仅其 39%
- MiMo-V2.6-Pro(46 / $0.13)仍是 46 分档价格锚点
- DeepSeek 1017(45 / $0.26)只低 1 分,账单是 MiMo 两倍
图 ② 斩杀线散点:谁在同能力下价格被碾压
斩杀区(红)
- Grok 4.7(46 / $3.74):同分贵 29 倍,压线被斩
- Qwen3.8 Max(45 / $5.41):国产旗舰里被斩得最狠
- GLM-5.3(45 / $2.01)仍在区内;旧 K3 已随换代退出当前榜
- Step 5 Preview 涨价 43% 后(44 / $1.03)陷得更深
能力溢出区(绿)
- Opus 5.5(58)独占榜首,Sonnet 5.5 与 Muse Wonder Full(56)随后
- K3.1 Pro(55 / $2.11)成为国产最高分,并进入绿区
- GPT-6.1 Sol(52 / $0.72)仍是最便宜的溢出区门票
- Muse Wonder(52 / $4.54)同分但比 Sol 贵 6.3 倍
两个锚点 + 两个挑战者
- MiMo-V2.6-Pro:46 分只卖 $0.13,仍是性价比线本体
- DeepSeek 1017:45 分 / $0.26,低价近身挑战不变
- K3.1 Pro:55 分比 MiMo 高 9 分,但账单是其 16.2 倍——高分与性价比不是同一冠军
图 ③ 每任务成本:同一个任务,账单最多差 127 倍
AA 用同一个加权任务包实测每个模型的账单。注意坐标是对数的:MiMo 兄弟的一格,等于 Opus 5.5 的将近两格。
图 ④ 输出速度:最快与最慢差 5.9 倍,但快不等于聪明
策展模型里最快的 Claude Haiku 5.5(234 t/s)是 K3.1 Pro(58 t/s)的约 4 倍,与最慢的 Qwen3.8 Max(40 t/s)差 5.9 倍。速度条和能力榜放在一起看才有意义:慢而贵需要理由,快而便宜是天赋。更深一层见第 03 节速度榜。
速度榜:K3.1 Pro 为什么仍比 DeepSeek 慢三倍
K3.1 Pro 普通版 AA 实测为 58 t/s,比旧 K3 官方端点的 38 t/s 提升约 53%,但 DeepSeek 1017 当前为 176 t/s,仍约为 K3.1 的 3 倍。Highspeed 官方称相对 K3.1 Pro 普速版快 2–3 倍,但尚未以独立条目进入 AA 本榜,不能把官方相对倍数当成跨模型实测。
速度 × 能力散点:快而强才是稀缺位置
又快又强(稀缺)
- Muse Wonder(162 / 52):Meta 新旗舰进入右上区
- Sonnet 5.5(134 / 56):高分阵营里同样破百
- Opus 5.5 是 58 分但 96 t/s——强,但不算快
快但弱(量产区)
- Haiku 5.5(234 / 43)速度王,还只要 $0.21
- DeepSeek 1017(176 / 45)、Ling 3.1 Flash(213 / 41)
- DS 速度快,但综合分已落后 K3.1 Pro 10 分
强但慢(深思区)
- K3.1 Pro(58 / 55):本组国产最高分,但不在高速区
- Qwen3.8 Max(40 / 45)、MiMo-Pro(59 / 46)、Astra(68 / 53)
- 适合不赶时间的难任务,别用来刷量
为什么 Kimi 不同模型、不同端点的速度差这么多
先说口径:AA 的输出速度 = 首 token 之后的平均生成速度,取过去 72 小时的 P50 中位数,每 3 小时复测一次,测速点固定在 Google Cloud us-central1;推理模型按答案后 80% 的 chunk 计速(剔除思考开头的抖动)。这套方法官方、连续、可复测,是目前最统一的速度标尺。
旧 K3 的历史数据能说明端点差异:Kimi 官方端点约 38 t/s,第三方服务商曾跑到 400+ t/s;但这些旧端点数字不能拿来冒充 K3.1 Pro 的实测。K3.1 Pro 当前可确认的是 AA 普通版 58 t/s,以及官方对 Highspeed「相对普速版 2–3 倍」的描述。要判断它是否比 DeepSeek 更适合你,仍需在同端点、同任务、同推理档下测总耗时。
Artificial Analysis 智能指数总榜
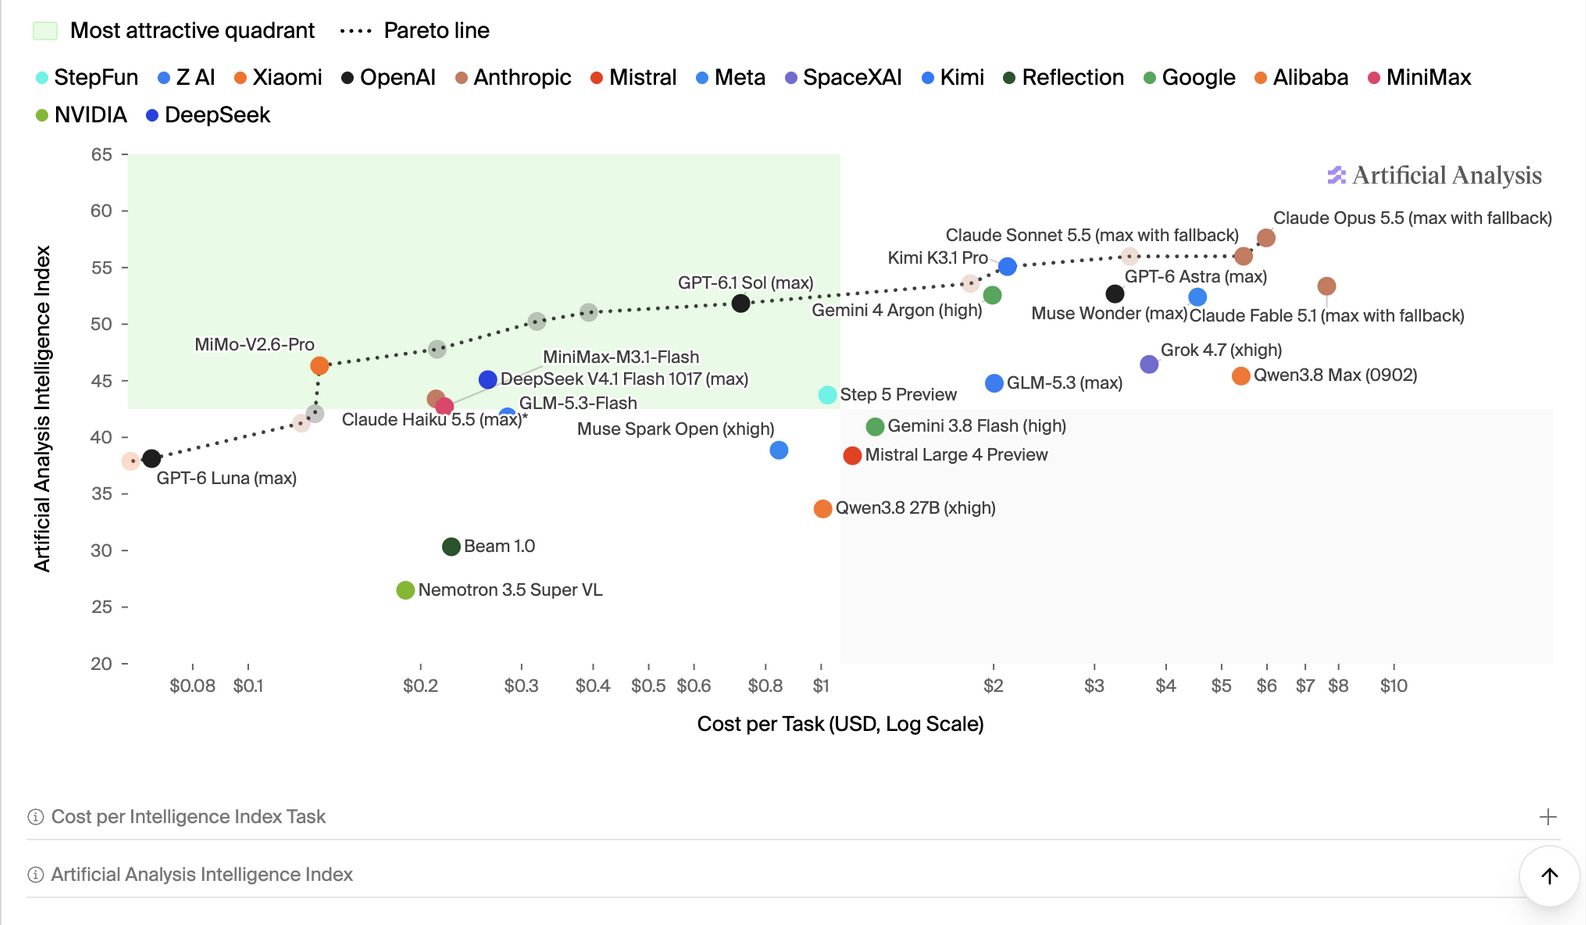
当前热度最高的第三方综合榜单。智能指数 v4.3.2 由 10 项评测加权(AA-Briefcase、GDPval-AA、AutomationBench-AA、Terminal-Bench 4.0、SciCode、HLE、GDP.pdf、CritPt、AA-Omniscience、AA-LCR),私有题占 45%。先放两张 2026-10-25 官网原图,再给中文提炼表。
官网原图直引 (2026-10-25 截取,未修饰)
圈内看模型能力基本只认这两张图:图 A 纯比能力——智能指数总榜,不问价格,谁分高谁强;图 B 能力 × 成本——把账单放进坐标轴,一眼看出谁「贵得有道理」、谁被性价比斩杀。绿色区域是 AA 官方标注的「最优象限」,虚线是帕累托前沿。
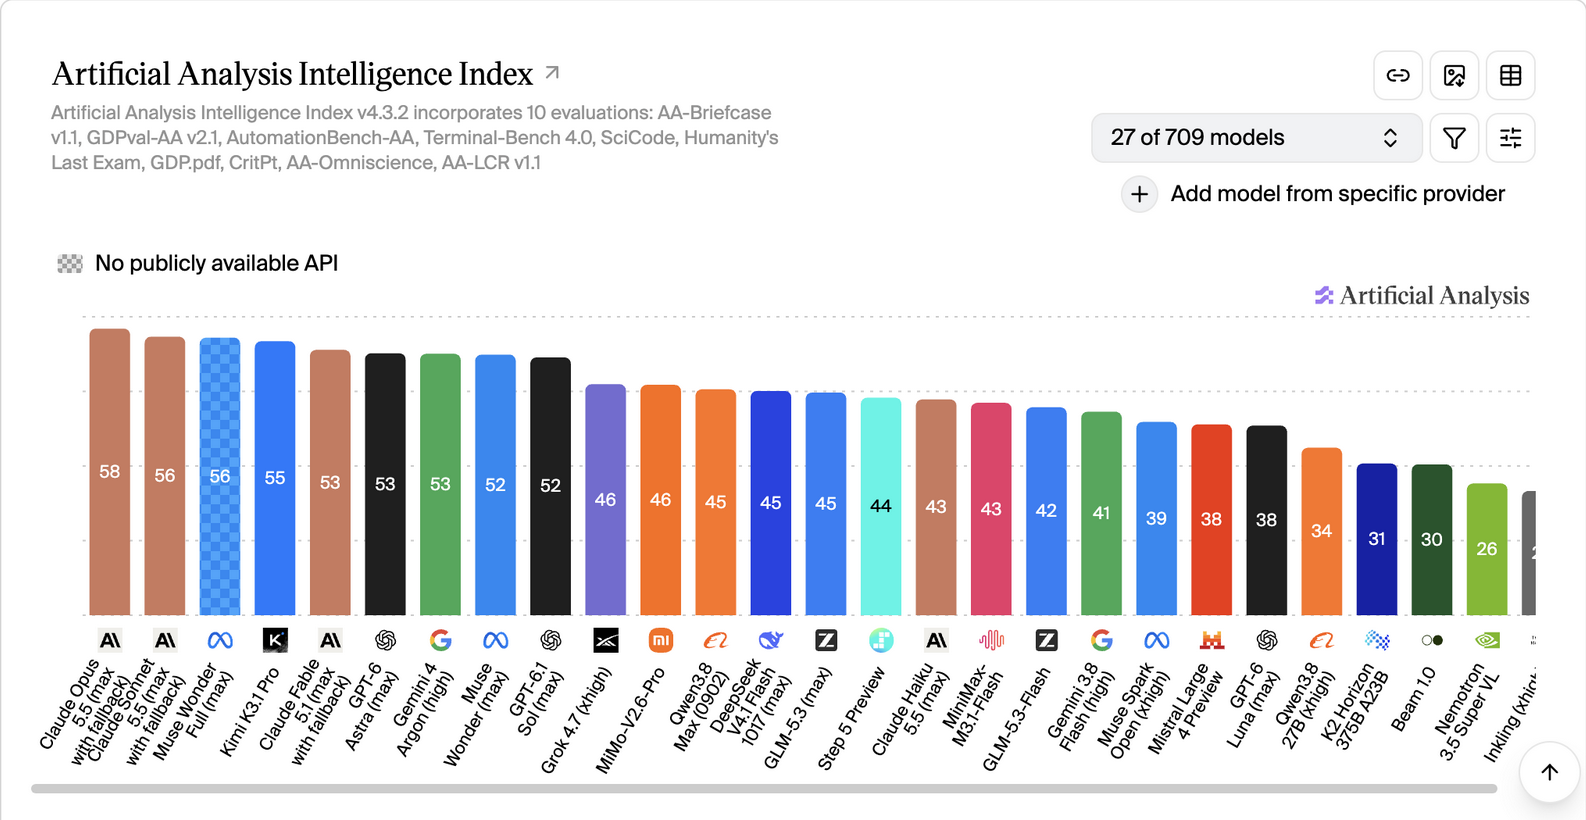
中文提炼榜 (上图的汉化重绘,国产金色底纹)
重点 29 款 + K3 历史对照 (按最高档分数排序,省略同模型低档)
| # | 模型(最高档位) | 实验室 | AA 指数 | 每任务成本 | 输出速度 |
|---|---|---|---|---|---|
| 1 | Claude Opus 5.5 (max) | Anthropic | 58 | $5.98 | 96 t/s |
| 2 | Claude Sonnet 5.5 (max) | Anthropic | 56 | $5.46 | 134 t/s |
| 3 | Muse Wonder Full (max) 无公开 API | Meta | 56 | — | — |
| 4 | Kimi K3.1 Pro 新收录 · 国产最高 | 月之暗面 | 55 | $2.11 | 58 t/s |
| 5 | Claude Fable 5.1 (max) | Anthropic | 53 | $7.63 | 70 t/s |
| 6 | GPT-6 Astra (max) | OpenAI | 53 | $3.26 | 68 t/s |
| 7 | Gemini 4 Argon (high) | 53 | $1.99 | 81 t/s | |
| 8 | Muse Wonder (max) | Meta | 52 | $4.54 | 162 t/s |
| 9 | GPT-6.1 Sol (max) | OpenAI | 52 | $0.72 | 59 t/s |
| 10 | Grok 4.7 (xhigh) | xAI | 46 | $3.74 | 96 t/s |
| 11 | MiMo-V2.6-Pro 小米 | 小米 | 46 | $0.13 | 59 t/s |
| 12 | Qwen3.8 Max (0902) 阿里 | 阿里 | 45 | $5.41 | 40 t/s |
| 13 | DeepSeek V4.1 Flash 1017 (max) | DeepSeek | 45 | $0.26 | 176 t/s |
| 14 | GLM-5.3 (max) 智谱 | Z.ai | 45 | $2.01 | 95 t/s |
| 15 | Ling 3.1 Flash 1019 | InclusionAI | 44 | $1.49 | 未测 |
| 16 | Step 5 Preview 阶跃星辰 | 阶跃星辰 | 44 | $1.03 ⚠️ | 230 t/s |
| 旧 | Kimi K3 (max) 10-24 历史快照 · 已被替换 | 月之暗面 | 44 | $2.00 | 38 t/s |
| 17 | Claude Haiku 5.5 (max) | Anthropic | 43 | $0.21 | 234 t/s |
| 18 | MiniMax-M3.1-Flash | MiniMax | 43 | $0.22 | 113 t/s |
| 19 | GPT-5.6 Terra (max) | OpenAI | 42 | $1.40 | 130 t/s |
| 20 | GLM-5.3-Flash 智谱 | Z.ai | 42 | $0.28 | 70 t/s |
| 21 | Ling 3.1 Flash 蚂蚁 | InclusionAI | 41 | $1.01 | 213 t/s |
| 22 | Gemini 3.8 Flash (high) | 41 | $1.24 | 141 t/s | |
| 23 | Qwen3.8 2.4T A95B 阿里 | 阿里 | 40 | $2.16 | 41 t/s |
| 24 | Qwen3.8-Flash-Next 阿里 | 阿里 | 40 | $0.37 | 52 t/s |
| 25 | Muse Spark Open (xhigh) | Meta | 39 | $0.84 | 151 t/s |
| 26 | Mistral Large 4 Preview | Mistral | 38 | $1.13 | 109 t/s |
| 27 | GPT-6 Luna (max) | OpenAI | 38 | $0.07 | 140 t/s |
| 28 | MiMo-V2.6-Flash 小米 | 小米 | 38 | $0.06 | 56 t/s |
| 29 | DeepSeek V4 Pro 0813 (max) DeepSeek | DeepSeek | 36 | $0.67 | 103 t/s |
性价比指数:能力 ÷ 账单
性价比指数 = AA 智能指数 ÷ 每任务成本(USD),以最高的小米 MiMo-V2.6-Flash = 100 归一化。它回答一个问题:同样的钱,谁给我的能力最多。K3.1 Pro 已按 55 / $2.11 参与计算,指数仅 4.1——它是国产高分冠军,不是性价比冠军。
讲法一
- MiMo-Flash(100)、Luna(85.7)、MiMo-Pro(55.9)守前三
- Haiku 5.5(32.3)第四,MiniMax M3.1 Flash(30.9)第五
- DeepSeek 1017(27.3)第六,GLM-5.3-Flash(23.7)随后
讲法二
- Fable 5.1(1.1)、Qwen3.8 Max(1.3)、Opus 5.5(1.5)垫底
- K3.1 Pro(4.1)略好于旧 K3(3.5),但仍远低于 DS(27.3)
- 预算敏感就别碰 max 档,降档通常省一半以上
讲法三
- 峰谷价仍在执行:非高峰半价(见第 08 节)
- 1017 性价比指数 27.3;若只按谷价粗算可翻倍至约 54.6
- 但 AA 每任务成本不等于你的动态账单,调度后需按真实 token 重算
其他榜单与 K3.1 早期风评
先看 K3.1 Pro 已确认什么、还缺什么,再看 LMArena、SWE-bench、Terminal-Bench 等分能力榜单。官方参数、厂商自测、第三方榜单、X 单次演示是四种证据,本页不混写;凡非官方一手抓取的数字都标 ⚠️。
Kimi K3.1 Pro 正式档案 (官方技术报告 + Artificial Analysis,2026-10-25)
| 维度 | K3.1 Pro / Highspeed | K3(历史对照) | 证据状态 |
|---|---|---|---|
| 定位与参数 | 官方称 3T 级;AA 披露 2.8T 总参数 / 104B 激活,显著增加后训练算力 | 上一代旗舰,2.8T | 官方技术博客 + AA |
| 代码 / 3D / 金融 | Terminal-Bench 4.0 官方自测 65.7%;Kimi Code Bench 3.0 为 61.2%(K3 为 55.95%);BenchCAD 92.7% | 长程编程、游戏 / 3D、知识工作 | 厂商自测,不与 AA 混算 |
| AA 综合表现 | 55 分 / $2.11 / 58 t/s,按模型最高档第 4;AA 另测 Terminal-Bench 67%、AutomationBench 73% | 历史快照 44 / $2.00 / 38 t/s | AA 第三方,当前主榜 |
| API 单价(每 M tokens) | 标准版 $2 / $10 / $0.20(¥13 / ¥68 / ¥1.30);Highspeed $4 / $20 / $0.20(¥26 / ¥136 / ¥1.30) | $3 / $15 / $0.30 | 输入 / 输出 / 缓存命中,官方价目 |
| 上下文与多模态 | 最高 1M;图片 + 视频输入 | 最高 1M;图片 + 视频输入 | Kimi Code 模型表 |
| 思考档位 | low / high / max,模型配置页默认 high;不可关闭思考 | low / high / max,默认 high | 当前官方文档为三档;早期 medium 传闻未采用 |
| 高速版 | 同模型效果,官方称约 2–3 倍输出速度、约 2 倍额度消耗;AA 目前只有普通版 58 t/s | 无同口径官方倍数 | 官方相对值,非跨模型实测 |
| 可用范围与权重 | Kimi.com / Kimi Work / Kimi Code / Kimi API 均已提供;权重承诺 11-04 前发布,当前尚未公开 | K3 权重已公开 | 「即将开放」不写成「已开源」 |
一手出处:Kimi K3.1 Pro 官方技术博客、Kimi Code 模型配置、官方价格指南、AA 发布专文。模型 ID 为 k3.1-pro 与 k3.1-pro-highspeed。
X / Twitter 早期风评 (10-22~10-24 抽样,非全量舆情统计)
偏正面:视觉与前端演示有记忆点
- @chetaslua:自报 15 分钟 one-shot 做出演示网站,有录屏;缺完整提示词、源码与重复运行
- @LuminaBench:3D 火车带速度滑块、爆炸视图与线框,交互完成度受好评
- @ChrisGPT:称连续使用一周、Three.js 表现好;更快更便宜的说法暂无日志支撑
反例:效果不稳与提示词偏移
- @kepochnik:Backrooms 游戏对比中对 K3.1 结果失望;单次作品,不能外推普遍排名
- @srikanthvaluri:Konark 日晷轮「设计好但偏简单」,雕刻细节不如 Gemini、报时功能不如 Opus
- @TimJayas:认为模型疑似自行纠正「骑自行车」提示词,指令遵循仍需复测
热度与传闻:不能当成跑分
- @Kimi_Moonshot 10-23:24 秒无文字 Three.js 预告,画面有 Kimi K3.1;浏览已超 172 万,但无跑分
- @ChrisGPT 的 Kibitz 对比:自报 $0.38 vs $5.31,但无账单与完整设置,且 Kibitz 身份未获官方确认
- 「成本低 14 倍」「开源已定」等说法均不进入本站数据图
LMArena 文本竞技场 (人类盲测偏好,Elo 式 Arena Score)
| # | 模型 | Arena Score | 备注 |
|---|---|---|---|
| 1 | Claude Mythos 5 | ≈1531 | ⚠️ 二手快照(Swfte,2026-09-19/23);头部 3–4 名分差在误差条内,实为统计平局。8 月底另一快照(ofox.ai)前三名为 Fable 5 / Opus 4.6 / Opus 4.7,头部变动频繁。 |
| 2 | Claude Fable 5 | ≈1525 | |
| 3 | Claude Opus 5 | ≈1522 | |
| 4 | GPT-5.6 Sol | ≈1514 | |
| 10 | Kimi K3(开源权重) | ≈1500 | 开源第一梯队 |
分榜亮点:WebDev 竞技场 GPT-6 Astra 1797 Elo 居首、Claude Fable 5.1 1762 紧随其后(⚠️ 二手,Crypto Briefing 2026-09-05)。K3.1 Pro 尚未以正式名称进入本页所引 LMArena 榜单;匿名 Kibitz 与 K3.1 的映射未获官方确认,不把匿名测试成绩记到 K3.1 名下。
SWE-bench Verified (真实 GitHub issue 修复,官方榜)
| # | 系统(Agent + 模型) | 解决率 | 提交日期 |
|---|---|---|---|
| 1 | Sonar Foundation Agent + Claude 4.5 Opus | 79.2% | 2025-12-05 |
| 1 | live-SWE-agent + Claude 4.5 Opus (medium) | 79.2% | 2025-12-15 |
| 3 | TRAE + Doubao-Seed-Code(字节) | 78.8% | 2025-09-28 |
| 4 | live-SWE-agent + Gemini 3 Pro Preview | 77.4% | 2025-11-20 |
| 5 | Claude 4.5 Opus (high) | 76.8% | 2026-02-17 |
Terminal-Bench 4.0 (K3.1 官方自测与 AA 第三方双口径)
| 模型 | 解决率 | 口径与出处 |
|---|---|---|
| Kimi K3.1 Pro | 67% | AA 独立评测,当前最高;旧 K3 为 13% |
| Claude Opus 5.5 | 66.4% | Kimi 官方技术博客对照值 |
| Claude Sonnet 5.5 | 64% | AA 发布专文对照值 |
| GPT-6 Astra | 58.2% | Kimi 官方技术博客对照值;与 09-08 旧榜相同 |
K3.1 Pro 在官方技术博客中的自测结果为 65.7%,AA 复测为 67%;运行配置不同,两个数字不取平均。原先基于 09-08 的「Astra 居首」旧榜已移至历史对照,不再冒充当前排名。AA 同时给出 AutomationBench-AA:K3.1 Pro 73%,旧 K3 为 58%。
推理与数学 (GPQA · AIME · HLE · FrontierMath)
GPQA Diamond
- GPT-6 Astra 96.1% 居首(modelgrep)
- Gemini 3.8 Flash 95.3%、Grok 4.6 94.9%
- 头部 94–96%,趋于饱和
AIME 2026
- Claude Opus 4.8 100% 满分
- GLM-5.2 99.2%(国产最高)
- 前 16 名 ≥ 95.83%,已基本饱和
Humanity's Last Exam
- Claude Opus 5.5 61.4% 居首
- Fable 5.1 59.1%、Fable 5 55.5%
- 带工具口径另有 65% 说法,引用需注明
其他:ARC-AGI-3(交互式新榜)GPT-6 Astra 62.7% 居首;FrontierMath v2 Tier 4 GPT-6 Astra 97.6%;LiveCodeBench 千问 Qwen3.7 Max 91.6% 领先(以上均为 ⚠️ 二手聚合,2026-09 中下旬)。
Flash 王座之争:默认模型该选谁
这不是旗舰总榜,而是给日常使用者的「高性价比默认模型」专题。10 月 25 日的格局是:DeepSeek 1017(45 分 / $0.26 / 176 t/s)守低价高速,Haiku 5.5(43 / $0.21 / 234 t/s)守速度,MiniMax M3.1 Flash(43 / $0.22 / 113 t/s)进入性价比前排;K3.1 Pro 以 55 分作为旗舰参照,但不参与 Flash 性价比冠军评选。比的仍然是完成一个合格任务的总成本。
DeepSeek V4.1 Flash 1017
- 对 K3.1 Pro:AA 总分 45 vs 55,落后 10 分;但账单仅约其 1/8.1、速度约 3 倍
- 每任务成本 $0.26,API 标价不变;峰谷价与 AA 账单是两种口径
- 谷价输出 $0.60/M,夜间批处理极省
- 图像理解可用,但视频 / 音频输入不在其能力范围内
GLM-5.3 Flash
- 能看页面/图片/视频并用渲染反馈继续修,少一次返工
- 官方支持 PPTX / PDF / DOCX / XLSX 交付闭环
- 官方输出标价 $0.39/M,限时五折 $0.20;促销后需按长期价重算
GPT-6 Luna
- 性价比指数 85.7,锚点地位 10 月让位于 MiMo-Flash
- 大厂合规与稳定性背书,免调度、无峰谷
- 能力下限:复杂 Agent 任务别指望它
Claude Haiku 5.5
- 10-07 发布:官方称成本比 Haiku 4.5 降 75%
- 大厂合规 + 快 + 分高,唯独不是最便宜
- 预算极限场景仍让位于 Luna / MiMo-Flash
MiniMax M3.1 Flash
- 官方 API $0.15 输入 / $0.60 输出每 M tokens
- 官方称线上速度提升近 3 倍、成本降低 70%;与 AA 测速口径不同
- 性价比指数 30.9,紧随 Haiku 之后,超过 DeepSeek 1017 的 27.3
Kimi K3.1 Pro 旗舰参照
- 比旧 K3 高 11 分,比 DeepSeek 1017 高 10 分
- API 单价比 K3 低 33%,但 AA 总账单并未低于旧 K3 的 $2.00
- 适合复杂代码、3D、金融研究;批量跑量仍先算 DS / MiMo 的总账
DeepSeek 1017 官方基准表 + AA 交叉验证 (厂商自测与第三方口径分列)
10-17 DeepSeek 发布 V4.1-Flash-1017(MIT 开源,API 名 deepseek-flash 不变、价格不变),并在 HuggingFace 模型卡里直接放出与 Kimi K3、GLM-5.3、Claude Opus 5 的对比表——11 项基准对 K3 十项明确胜出。加粗 = 该行全场最高;† = 仅文本子集成绩(HLE 含图像题)。
| 基准 | V4.1-Flash-1017 | V4.1-Flash(0910) | Kimi K3 | GLM-5.3 | Claude Opus 5(参照) |
|---|---|---|---|---|---|
| HLE(无工具) | 42.6(†44.0) | 36.8 | 43.5 | †42.0 | 56.3 |
| Terminal-Bench 4.0 | 42.3 | 31.2 | 12.6 | 37.9 | 51.8 |
| DeepSWE v1.1 | 77.0 | 74.2 | 67.5 | 66.9 | 74.0 |
| ProgramBench | 29.1 | 20.3 | 17.5 | 19.0 | 37.0 |
| NL2Repo | 68.2 | 65.4 | 58.0 | 58.0 | 75.3 |
| Automation-Bench | 60.5 | 54.8 | 46.7 | 48.8 | 50.3 |
| Agents' Last Exam | 35.4 | 31.8 | 27.6 | 28.5 | 28.6 |
| Apex Bench | 72.1 | 64.6 | 47.8 | 56.6 | 65.8 |
| Chartography(视觉) | 83.0 | 78.9 | 68.1 | 未测 | — |
| BabyVision(视觉) | 92.5 | 89.6 | 85.7 | — | — |
| ZeroBench(视觉) | 51.0 | 49.0 | 41.0 | — | — |
| 场景 | 建议默认模型 | 理由 |
|---|---|---|
| 批量文本清洗 / 分类 / 摘要 | 夜间 DeepSeek V4.1 Flash,白天 GPT-6 Luna 或 MiMo-Flash | DeepSeek 谷价便宜但需调度;Luna 全天同价省心;MiMo-Flash 底价最狠 |
| 前端 / GUI / 视觉验收 | GLM-5.3 Flash;复杂 3D 可加试 K3.1 Pro | GLM 有交付闭环;K3.1 的 AA 与官方 3D 证据更充分,但仍需验收实际作品 |
| Office / PPT / 金融交付 | GLM-5.3 Flash;K3.1 Pro 重点候选 | GLM 有现成交付闭环;K3.1 的金融研究方向明确,先用真实任务验收 |
| 超低延迟短任务 | Claude Haiku 5.5(234 t/s) | 本组最快;DeepSeek 1017(176 t/s)次之 |
| 极限底价跑量 | 小米 MiMo-V2.6-Flash($0.06/任务) | 56 t/s 偏慢,适合不赶时间的后台任务 |
| 复杂代码 / 3D 创作 | K3.1 Pro 可作为新默认候选 | AA 55 分、AA Terminal-Bench 67% 与官方技术报告已落地;生产迁移仍先做小样本回归测试 |
| 报价与预算 | 一律按长期价报价 | GLM 五折与 DeepSeek 谷价都是变量,不算进底价 |
官方价格表与峰谷价
各家官网标价(K3.1 及变动项于 10-25 复核,其余沿用前次核对),国产模型按人民币官价以 ≈7.1 汇率折算为美元。AA 的「每任务成本」与下表标价是两种口径:前者是实测账单,后者是价目表;Highspeed 的普通输入、输出和缓存写入价约为标准版 2 倍,缓存命中价相同。
旗舰梯队 ($/百万 tokens)
| 模型 | 输入 | 输出 | 缓存命中 | 上下文 | 备注 |
|---|---|---|---|---|---|
| OpenAI GPT-6 Astra | $10.00 | $50.00 | $1.00 | 1.05M | 长上下文档 $20/$75 |
| Anthropic Claude Fable 5.1 | $10.00 | $50.00 | $0.25 | 1M | 缓存读 9 月降价 75% |
| Anthropic Claude Opus 5.5 | $4.00 | $20.00 | $0.20 | 1M | 比 Opus 5 便宜约 40% |
| Anthropic Claude Sonnet 5.5 | $2.00 | $10.00 | $0.10 | 1M | 09-28 发布,与 Sonnet 5 同价 |
| Google Gemini 4 Argon | $2.00 | $10.00 | — | 1M | 09-30 发布,限 Fairwind 计划分批开放 |
| 月之暗面 Kimi K3.1 Pro | $2.00(¥13) | $10.00(¥68) | $0.20(¥1.30) | 最高 1M | 标准 API;权重承诺 11-04 前发布 |
| 月之暗面 Kimi K3.1 Pro Highspeed | $4.00(¥26) | $20.00(¥136) | $0.20(¥1.30) | 最高 1M | 常规价约 2 倍,缓存命中同价 |
| 月之暗面 Kimi K3 | $3.00(¥20) | $15.00(¥100) | $0.30 | 1M | 历史对照;K3.1 单价约降 33% |
| xAI Grok 4.7 ⚠️ | $2.00 | $6.00 | $0.50 | 500K | 多源一致,待官网复核 |
| Google Gemini 3.1 Pro ⚠️ | $2.00 | $12.00 | — | >200K 升档 | 多源一致,待官网复核 |
| 智谱 GLM-5.3 | $1.13(¥8) | $3.94(¥28) | ¥2 | 1M | 缓存存储限时免费 |
| 阿里 qwen3.8-max | $1.69(¥12) | $5.07(¥36) | 有折扣 | 1M | Batch 半价 |
| DeepSeek V4 Pro(峰/谷) | $1.32 / $0.66 | $3.96 / $1.98 | $0.044 / $0.022 | 1M | 最大输出 384K |
| 腾讯混元 Hy4 preview | $0.83(¥6) | $2.50(¥18) | ¥0.3 | 1M | 开源 Apache 2.0 |
低价 / Flash 梯队 ($/百万 tokens)
| 模型 | 输入 | 输出 | 上下文 | 备注 |
|---|---|---|---|---|
| OpenAI GPT-6.1 Sol | $2.00 | $10.00 | 1M | 缓存 $0.10;Ultrafast 层 $12/$60(10-08) |
| Google Gemini 3.8 Flash ⚠️ | $0.75 | $3.75 | 1M | 促销价至年底,2027 起翻倍 |
| OpenAI GPT-6 Luna | $0.10 | $0.50 | 长档 $0.20/$0.75 | 缓存 $0.01 |
| Anthropic Claude Haiku 5.5 | $0.10 | $0.50 | 1M | 10-07 发布,成本比 Haiku 4.5 降 75% |
| MiniMax M3.1 Flash | $0.15 | $0.60 | 1M | 缓存输入 $0.015;10-19 发布 |
| 小米 MiMo-V2.6-Flash | $0.14(¥1) | $0.28(¥2) | 1M | MIT 开源 309B/15B |
| 智谱 GLM-5.3-Flash | $0.11(¥0.8) | $0.39(¥2.8) | 1M | 限时五折 ¥0.4/¥1.4 |
| 阿里 qwen3.8-flash | $0.11(¥0.8) | $0.38(¥2.7) | 1M | — |
| DeepSeek V4.1-Flash(峰/谷) | $0.30 / $0.15 | $1.20 / $0.60 | 1M | 缓存命中 $0.006/$0.003 |
| 腾讯混元 Hy3 | $0.14(¥1) | $0.56(¥4) | — | TokenHub 平台 |
数据出处与口径说明
本页所有结论可溯源。一手来源优先;标 ⚠️ 的数字来自第三方快照或聚合站,发布前已交叉验证、仍建议核对原站。
- Artificial Analysis 智能指数 v4.3.2 模型总榜与 K3.1 Pro 发布专文(55 / $2.11 / 58t、第 4、Terminal-Bench 67%、输出 token 55K;专文较早成本 $1.98 已在页面注明)2026-10-25 抓取
artificialanalysis.ai/leaderboards/models、K3.1 Pro 模型页、K3.1 Pro 发布专文;第 04 节两张官网原图来自同日截图 - Artificial Analysis 性能测试方法(输出速度 = 首 token 后平均速度、72 小时 P50、每 3 小时复测)与旧 K3 服务端点对比2026-10-25
artificialanalysis.ai/methodology/performance-benchmarking、旧 K3 providers;OpenRouter · K3.1 Pro - Kimi K3.1 Pro 官方技术博客、模型配置与价格指南(3T / 1M / 代码 / 3D / 金融研究、Highspeed、$2/$10/$0.20、权重 11-04 前发布)2026-10-25
官方技术博客;Kimi Code 模型配置;官方价格指南 - Kimi API 开放平台价目(K3.1 Pro / Highspeed / K3 独立 API 价)2026-10-25 复核
platform.kimi.com/docs/pricing/chat - K3.1 官方 X 预告与早期用户帖(单次演示,非严格复现;Kibitz 身份未获官方确认)2026-10-22~24 抽样
官方预告;网页演示;3D 火车;游戏反例;细节对比;提示词偏移反馈;Kibitz 成本自报 - Meta 官方 Muse Wonder / Wonder Full 发布页(10-12;分数、成本与速度另取 AA 同快照)2026-10-24 复核
about.fb.com/.../introducing-muse-wonder-models - MiniMax M3.1 Flash 官方发布博客(10-19;$0.15 / $0.60 / $0.015、官方相对速度与成本口径)2026-10-24
minimax.io/blog/minimax-m31f;M3 原生多模态口径(06-01) - Anthropic 官方定价与发布页(Opus 5.5 / Sonnet 5.5 / Haiku 5.5 / Fable 5.1)2026-10-12
platform.claude.com/docs/en/about-claude/pricing;Sonnet 5.5(09-28);Haiku 5.5(10-07);Opus 5.5 系统卡(PDF) - OpenAI 官方定价与发布页(GPT-6 Astra / GPT-6.1 Sol / GPT-6 Luna)2026-10-12
platform.openai.com/docs/pricing;GPT-6.1 Sol(09-29 DevDay) - Google Gemini 4 Argon 官方博客(09-30,Fairwind 计划分批开放)2026-10-12
blog.google/.../gemini-4-argon - DeepSeek 官方定价与峰谷价、更新日志(含 10-17 的 V4.1-Flash-1017 与自研搜索 API 条目)2026-10-17 复核
api-docs.deepseek.com/quick_start/pricing;api-docs.deepseek.com/updates - DeepSeek-V4.1-Flash-1017 HuggingFace 官方模型卡(MIT 开源;第 07 节 1017 / 0910 / Kimi K3 / GLM-5.3 / Opus 5 对比表原始出处,厂商自测口径)2026-10-17
huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash-1017;报道参考 量子位 2026-10-17 - 阶跃星辰开放平台定价(Step 5 Preview 调价公告:缓存命中价 10-14 起翻倍 + 峰谷价)2026-10-12
platform.stepfun.com - 智谱开放平台定价(GLM-5.3 / 5.3-Flash 及限时五折)2026-10-12
open.bigmodel.cn/pricing - 阿里百炼计费说明(qwen3.8-max / flash)2026-10-12
help.aliyun.com/zh/model-studio/billing-for-model-studio;云栖大会报道 量子位 2026-09 - 小米 MiMo-V2.6-Flash(09-22 开源发布,MIT,309B/15B)与蚂蚁 Ling 3.1 Flash(09-30,InclusionAI;1019 数据取 AA 10-24 快照)2026-10-24 复核
github.com/XiaomiMiMo;github.com/inclusionAI - 腾讯 TokenHub 官方文档(混元 Hy4 preview / Hy3、Kimi K3 转售价)2026-09-22 更新
cloud.tencent.com/document/product/1823/130055 - SWE-bench Verified 官方榜单数据(GitHub 数据仓库)文件更新 2026-09-01
SWE-bench/swe-bench.github.io - ⚠️ LMArena 文本竞技场二手快照2026-09-19/23
swfte.com/lmarena;ofox.ai(2026-08-31)(官网 JS 渲染无法直接抓取) - Terminal-Bench 4.0 当前对照(K3.1 Pro:AA 67%;官方自测 65.7%)与历史整理数据当前项 2026-10-25;历史项 2026-09-08
AA 发布专文;Kimi 官方技术博客;codingfleet(历史快照) - ⚠️ GPQA / HLE / ARC-AGI / LiveCodeBench 等聚合数据2026-09 中下旬
modelgrep.com;benchlm.ai;evals.report - ⚠️ xAI Grok 4.7 / Google Gemini 3.1 Pro 价格(官网抓取失败,多源一致)2026-09-18~22
The Decoder;Codersera
口径与方法
① 能力分一律采用 AA 智能指数 v4.3.2(2026-10-25 快照);推理档位曲线取 AA 同一快照下各模型 medium / high / xhigh / max 档位的分数与每任务成本。旧 K3 只保留历史对照,不与 K3.1 Pro 重复进入当前排名。第 07 节 DeepSeek 官方表为厂商自测口径,与 AA 第三方口径分列、不混用。 ② 「每任务成本」为 AA 按固定加权任务包实测账单,与官网标价是两种口径,第 02/05 节用前者,第 08 节给后者;AA 发布专文的 $1.98 与当前主榜 $2.11 属不同快照,本页统一用后者。 ③ 斩杀区定义:AA 指数 ≤ 斩杀线本体(MiMo-V2.6-Pro,46 分)且每任务成本 ≥ $0.13;能力溢出区 = 指数 ≥ 48。 ④ 性价比指数 = AA 指数 ÷ 每任务成本,MiMo-V2.6-Flash = 100 归一化。 ⑤ 汇率:人民币官价按 ≈7.1 折算为美元,仅作同页比较。 ⑥ 速度口径:AA 输出速度 = 首 token 后平均生成速度的 72 小时 P50 中位数(每 3 小时复测,测速点 us-central1);同一模型不同服务商端点差距可达数倍,本页以 AA 默认端点口径为准,选购时以目标端点实测为准。 ⑦ K3.1 Pro 已按 55 / $2.11 / 58 t/s 进入全部相关图表;权重承诺 11-04 前发布,当前仍属未公开,不能写成「已开源」。Kibitz 身份未获官方确认,相关成本与跑分传闻不参与图表计算。其他待确认项(Qwen4、Gemini 3 Deep Think 评分)同样不进入图表。 ⑧ X 风评是 10-22~10-24 的公开帖子抽样,不是全量舆情或正负面比例统计;单次录屏只说明该次结果,不证明生产稳定性、普遍排名或真实账单。
本页为数据整理与可视化作品,不构成任何采购建议;模型能力随版本快速变化,请以原始出处最新数据为准。
© 2026 你猜吧 | 京ICP备2026059588号 | 京公网安备11010802050250号 | 返回你猜吧主页 →